Досить часто продуктивність є ключовим елементом, який робить клієнтів або дуже задоволеними рішенням, або дуже незадоволеними. Ми, в Xpand, бачили мільйони рядків коду, і я мушу визнати, що розробники NAV занадто рідко замислюються про швидкість виконання того, що вони пишуть. Хоча це досить захоплива тема, ми не будемо обговорювати її в цій статті. Натомість давайте зосередимося на тому, як переписати код за допомогою запитів і збільшити швидкість рішення в тисячу разів!
РОЗУМІННЯ ОСНОВ
Перш ніж ми заглибимося в приклади та запити, важливо зрозуміти, що відбувається на SQL-сервері, коли ми пишемо такі прості команди, як FINDSET. Давайте перевіримо це!

Уявіть, що у нас є наступний простий код:
ЗаписКлієнтськоїКниги.СКИДАННЯ;
ЗаписКлієнтськоїКниги.FINDSET;
Коли ви його виконаєте, NAV перетворить цей код на оператор T-SQL, подібний до наведеного нижче:
ВИБЕРІТЬ "timstamp", "Entry No_", "Client No_", "Data of Document", "Document Type", "Document No_", "Description", "Currency Code", "Prodays (LCY)", "Profit (LCY)", "Inv_Znizka (LCY)", "Prodate-Client No_", "Company entry Group", "Group of Client entry", "Global Payment Code 1", "Global Payment Code 2", "Salesmen's Code", "Underground", "Activated-to-Doc_ Type", "Activated-to-Doc_ No_", "Open", "Date of complete", "Pmt_ Discount Možlive", "Pmt_ Discount No (LCY)", "Positive", "Closed by Enter No_", "Closed on Date", "Closed for Sum", "Activated-to-ID", "Journal Payment Party", "Reason Code", "Sald_ Account Type", "Sald_ Account Type", "Sald_ Account Type" №_", "Транзакція №_", "Закрито сумою (LCY)", "Дата документа", "Зовнішній документ №_", "Розрахувати відсотки", "Розраховані відсотки за закриття", "№ серії", "Закрито кодом валюти", "Закрито сумою валюти", "Скоригований коефіцієнт валюти", "Початковий коефіцієнт валюти", "Залишок можливого списання платіжної суми", "Дата допуску списання платіжної суми", "Максимальний допуск платежу", "Рівень останнього нагадування", "Допуск прийнятого платежу", "Допуск прийнятого списання платіжної суми", "Допуск списання платіжної суми (LCY)", "Сума до застосування", "Код партнера IC", "Застосування запису", "Скасовано", "Скасовано номером запису", "Номер сторнованого запису", "Передаплата", "Код способу оплати", "Застосовується до зовнішнього номера документа", "Банківський рахунок отримувача", "Повідомлення отримувачу", "Експортовано до файлу платежу", "Набір вимірів Ідентифікатор", "Ідентифікатор доручення на прямий дебет"
З "Xpand".dbo."CRONUS International Ltd_$Запис у реєстрі клієнтів" З (ЗЧИТАННЯ НЕ ЗАФІКСИРАНО)
ВОРОТІТЬ ЗА "Номер запису_" ОПЦІЯ ЗА ЗРОСТАННЯМ (ОПТИМІЗАЦІЯ ДЛЯ НЕВІДОМИХ, FAST 50)
ПРОБЛЕМА 1. ЗАНАДТО БАГАТО ПОЛІВ
Як бачите, NAV отримає всі поля з таблиці CustLedgerEntry в інструкцію SELECT. Це дуже зручно, тому що пізніше, коли ви захочете прочитати значення з будь-якого поля запису CustLedgerEntry, NAV вже матиме його, і жодного додаткового інструкцію не потрібно буде надсилати. Отже, коли ви зробите щось подібне:
ЗаписКлієнтськоїКниги.СКИДАННЯ;
IF CustLedgerEntry.FINDSET THEN
ПОВТОР
ЯКЩО CustLedgerEntry.Amount > 0, ТО ПОЧАТИ
// будь-яка дія
// будь-яка дія
КІНЕЦЬ;
ДОКИ CustLedgerEntry.NEXT = 0;
і ви перевіряєте значення в полі «Сума», система вже матиме значення з поля «Сума». По суті, оскільки NAV не знає заздалегідь, які значення вам можуть знадобитися після виконання оператора FINDSET, він отримує значення для всіх полів всередині оператора SELECT. Фактично, щоразу, коли ви пишете оператор FINDSET, система надсилає команду SELECT * на SQL-сервер, навіть якщо вам насправді може знадобитися лише один стовпець із вашого запису.
Зазвичай це вважається поганою практикою з кількох причин:
1) З SELECT * ми просто отримуємо забагато даних. Це призводить до переміщення більшої кількості даних, ніж потрібно, від SQL-сервера до клієнта, що уповільнює продуктивність, щонайменше збільшуючи трафік. Це здається досить простим, але на великих таблицях різниця може бути вражаючою.
2) За допомогою SELECT * система завжди має повертатися до кластерного індексу, щоб отримати значення для полів, які не були проіндексовані та не існують у вторинному ключі. Існує термін, який називається покриваючим індексом. Ось опис від Microsoft: « Покриваючий індекс – це індекс, який містить усі вихідні поля, необхідні для операції, що виконується над цим індексом. Стратегія доступу до даних покриваючого індексу може значно покращити продуктивність, оскільки база даних повинна отримувати лише дані з індексу, а не знаходити дані за допомогою індексу, а потім отримувати дані з кластерного індексу». Розглянемо приклад.
ЗаписКлієнтськоїКниги.СКИДАННЯ;
CustLedgerEntry.SETRANGE("Номер зовнішнього документа.",ExternalDocumentNo);
ЗаписКлієнтськоїКниги.FINDSET;

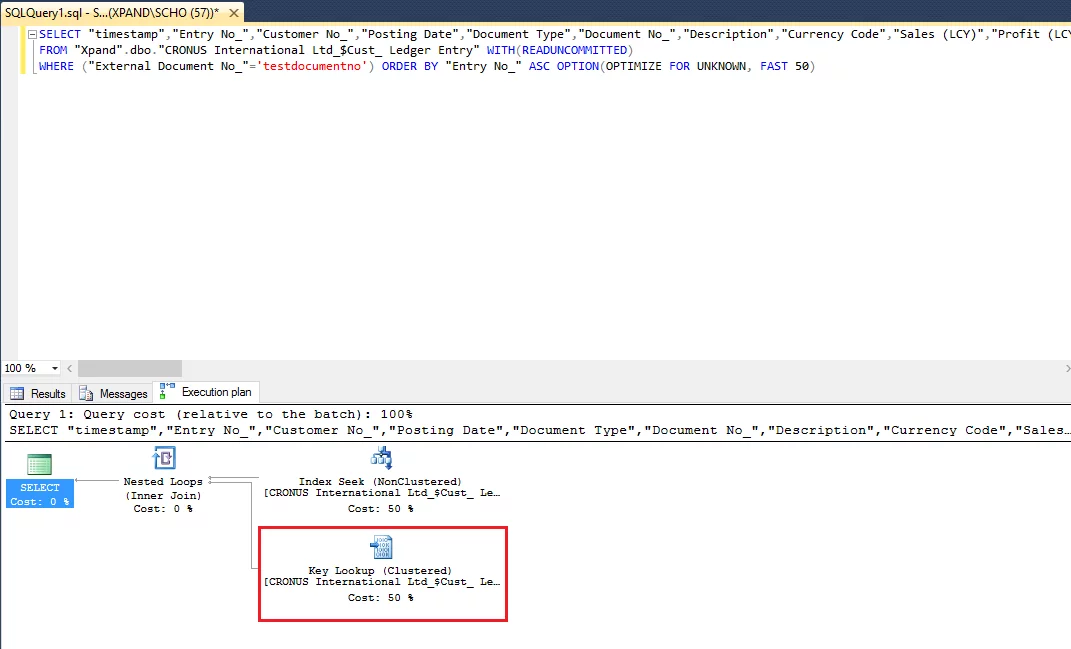
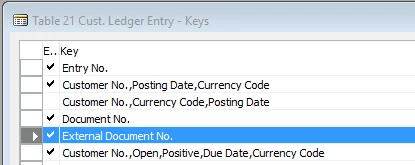
Як видно з плану виконання, система вибрала некластеризований індекс (той, що ви бачите на скріншоті нижче), виконала там пошук записів, але не змогла знайти значення для всіх полів індексу, тому виконала пошук за первинним ключем (кластеризованим індексом).

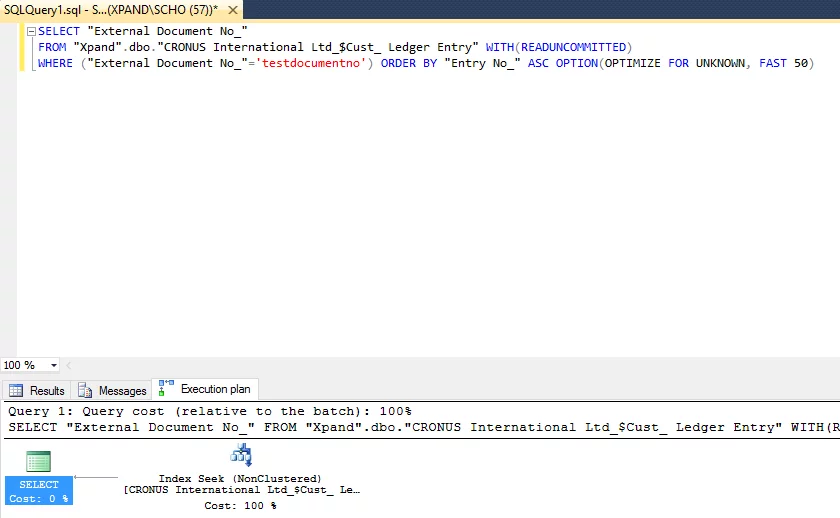
Обидві операції, пошук за індексом та пошук за ключем, займали приблизно 50%, а це означає, що якби використаний нами індекс містив усі необхідні поля, наш запит був би вдвічі швидшим! Або, з іншої точки зору, якби нам потрібні були (і ми вказали це в нашій інструкції SELECT) лише поля, доступні в нашому некластеризованому індексі, ми б мали величезне збільшення продуктивності:

Якщо хтось із Microsoft читає цю статтю, будь ласка, подумайте про те, щоб дозволити нам визначати необхідні поля для кожної окремої змінної типу Record, або змінити компілятор таким чином, щоб він автоматично перевіряв усі способи використання змінної та виконував правильний оператор SELECT лише з використаними полями всередині. J
ЗАДАЧА 2. ПЕТЛЯ ВСЕРЕДИНІ ПЕТЛІ
Дуже часто розробники пишуть оператор REPEAT...UNTIL всередині іншого оператора REPEAT...UNTIL. Наприклад, вам може знадобитися переглянути певних клієнтів, а потім перебрати їхні рахунки-фактури. Це завдання не здається дивним чи складним для виконання. Більшість розробників написали б щось на кшталт цього:
Customer.RESET;
Customer.SETRANGE("Код валюти",'');
ЯКЩО Customer.FINDSET THEN
ПОВТОР
SalesHeader.СКИДАННЯ;
SalesHeader.SETRANGE("Номер клієнта-продавця", "Номер клієнта");
ЯКЩО SalesHeader.FINDSET ТО
ПОВТОР
// будь-яка дія
ДОКИ SalesHeader.NEXT = 0;
ДОКИ Customer.NEXT = 0;
Б'юся об заклад, ви бачили цю структуру купу разів. Дехто з вас, можливо, навіть бачив інший рівень циклу — під записом SalesHeader. І, на жаль, це погано, оскільки це надзвичайно знижує продуктивність. За допомогою цієї структури ми створюємо системний цикл для кожного окремого запису (який, звичайно, відповідає фільтру) у таблиці Customer, а потім, у таблиці Sales Header, для кожного запису Customer. Це займає багато часу (особливо для великих таблиць) і завжди робить ваші рішення схожими на це:
РІШЕННЯ
Існує досить просте рішення для обох проблем -> об'єкт типу Query! Давайте спочатку дізнаємося, як це може допомогти.
з першою проблемою. Річ у тім, що коли ви виконуєте запит з
визначений список полів, система надсилає оператор SELECT ТІЛЬКИ для полів
які були визначені в запиті. Не всі поля, а лише ті, які вам дійсно потрібні.
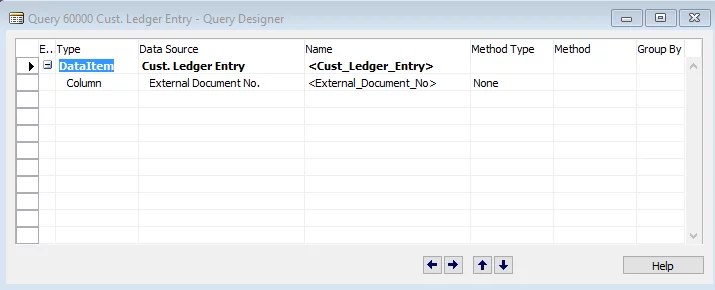
Наприклад, створимо наступний запит:

Після виконання його з наступним кодом:
ОЧИСТИТИ(ЗапитЗаписуКлиєнтаКнигиКлієнта);
ЗапитЗаписуКлієнтськоїРеєстри.ВІДКРИТО;
ПОКИ CustLedgerEntryQuery.READ DO
ПОЧАТОК
// будь-яка дія
КІНЕЦЬ;
ЗапитЗаписуКнигиКлієнта.ЗАКРИТИ;
система згенерує T-SQL-запит, подібний до наведеного нижче:
ВИБЕРІТЬ "Запис_книги_клієнта"."Зовнішній_номер_документа_" AS "Зовнішній_номер_документа_","Запис_книги_клієнта"."Запис_" AS "Запис_книги_клієнта$Запис_"
FROM "Xpand".dbo."CRONUS International Ltd_$Запис_Книги_Клієнта" AS "Запис_Книги_Клієнта" WITH(ЗЧИТАННЯНЕПІДТВЕРДЖЕНО)
ВОРОТ ЗА "Cust_Ledger_Entry$Entry No_" ОПЦІЯ ЗА СПІВРОБІТНІСТЮ (ОПТИМІЗАЦІЯ ДЛЯ НЕВІДОМИХ, FAST 50, ПРИМУШЕНЕ ВОРОТ, ЦИКЛОВЕ ПРИЄДНАННЯ)
Як бачите, система вибирає лише поле «Номер зовнішнього документа». Це досить круто, тому що ми а) запитуємо в SQL лише те, що нам дійсно потрібно, і б) у багатьох випадках ми можемо виключити пошук за ключем у кластерному індексі, оскільки ми можемо скористатися перевагою покривного індексу, який містить усі поля в некластерному індексі. Ніяких зайвих даних, жодного надмірного навантаження на мережу та оперативну пам'ять, а також жодного додаткового пошуку полів, які нам просто не потрібні, і які можна взяти безпосередньо з некластерного індексу. Чисте підвищення продуктивності.
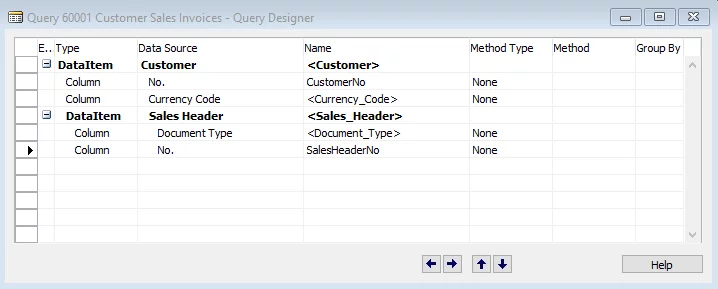
Тепер, щоб вирішити проблему «циклу всередині циклу», ви можете створити дуже простий запит, який виконував би просте об’єднання двох таблиць. Давайте використаємо наш приклад вище та створимо наступний запит:

І виконаємо його. Ми отримаємо один SQL-запит:

Таким чином, ми отримаємо один запит лише з тими полями, які нам потрібні, і, що ще важливіше, нам доведеться виконувати цикл лише один раз і лише з результуючим набором:
CLEAR(Рахунки-фактуриКлієнта);
Рахунки-фактуриКлієнтаПродажі.SETRANGE(Код_валюти,'');
Рахунки-фактуриКлієнта.ВІДКРИТО;
ПОКИ CustomerSalesInvoices.READ ВИКОНАНО
ПОЧАТОК
// будь-яка дія
КІНЕЦЬ;
Рахунки-фактури CustomerSalesInvoices.CLOSE;
Збільшення швидкості в цьому випадку вражає майже в кожному випадку. А під вражаючим ми маємо на увазі пришвидшення в 10 або навіть 100 разів.
У цій статті ми розглянули лише дві невеликі проблеми, які можна було б вирішити вже сьогодні з дійсно потужними результатами. Ми вважаємо, що впровадження запитів у NAV 2013 було недооцінено партнерами, і ми дуже рекомендуємо використовувати їх. Так само, як ми робимо це у нашій щоденній розробці. J